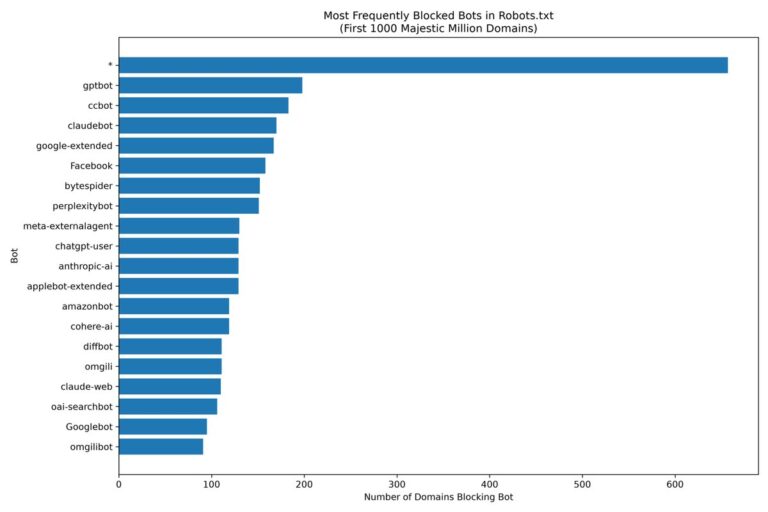
PerplexityBot is in november 2026 de crawler waarmee Perplexity websites in zijn zoekresultaten kan tonen. In de officiële documentatie van Perplexity staat dat deze bot niet wordt gebruikt om content te verzamelen voor AI-basismodellen. Hij heeft een eigen user-agent, volgt robots.txt, en wijzigingen kunnen tot 24 uur duren voordat ze doorwerken. Dat is iets anders dan GPTBot in robots.txt of Google-Extended, die over andere systemen gaan.
Wat is PerplexityBot?
Perplexity beschrijft PerplexityBot als de bot die sites in de zoekresultaten op Perplexity naar voren moet kunnen halen en ernaar kan linken. Wil je in die resultaten verschijnen, dan adviseert Perplexity om PerplexityBot in robots.txt toe te staan en verzoeken vanaf de gepubliceerde IP-reeksen toe te laten. Een voorbeeld van de user-agent, waarbij het versienummer kan wijzigen, is: Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot). De actuele IP-adressen staan op perplexity.ai/perplexitybot.json.
Dat is de crawler voor de zoekindex van Perplexity, niet dezelfde vraag als “word ik genoemd in een antwoord”. Hoe je in Perplexity zichtbaar kunt worden, staat in het stuk over gevonden worden in Perplexity. Deze tekst gaat over de bot en over robots.txt.
En Perplexity-User?
Daarnaast is er Perplexity-User. Die user-agent ondersteunt acties van een gebruiker in Perplexity. Als iemand een vraag stelt, kan de dienst een webpagina ophalen om een nauwkeuriger antwoord te geven, met een link naar die pagina. Perplexity-User bepaalt welke sites die gebruikersverzoeken mogen benaderen, schrijft de documentatie. Ook deze agent wordt volgens Perplexity niet gebruikt om het web te crawlen of om content te verzamelen voor het trainen van basismodellen. Een voorbeeldstring is: Mozilla/5.0 (compatible; Perplexity-User/1.0; +https://perplexity.ai/perplexity-user). De IP-reeksen staan op perplexity.ai/perplexity-user.json.
Belangrijk verschil: omdat een gebruiker om de ophaalactie vraagt, negeert deze fetcher robots.txt-regels in de regel, zegt Perplexity zelf. Een Disallow voor Perplexity-User in robots.txt is dus geen betrouwbare blokkade. Wie die verzoeken wilt beperken, moet naar andere maatregelen kijken, bijvoorbeeld op serverniveau, en ook dan de officiële documentatie volgen.
Zo zet je het in robots.txt
Elke instelling werkt volgens Perplexity onafhankelijk, en het kan tot 24 uur duren voordat een wijziging zichtbaar is. Een toelating voor de zoekcrawler ziet er zo uit:
User-agent: PerplexityBot
Allow: /
Een blokkade van de zoekcrawler:
User-agent: PerplexityBot
Disallow: /
Zet de regels op een eigen blok, niet op één hoop met GPTBot of andere agents. Test na een wijziging of het bestand bereikbaar is op /robots.txt, en geef de 24 uur de tijd voordat je conclusies trekt uit logboeken.
Let op een firewall
Gebruik je een WAF, dan kan een beveiligingsregel de bot tegenhouden, ook als robots.txt hem toestaat. Perplexity beschrijft dat je in dat geval de bot expliciet moet toestaan, en raadt aan om zowel de user-agent als de officiële IP-reeksen te gebruiken, niet alleen een van de twee. Die reeksen wijzigen; de JSON-bestanden zijn volgens de documentatie de bron. Kopieer geen oude lijst uit een blog.
Vier keuzes die je niet moet mengen
PerplexityBot en Perplexity-User zijn twee user-agents, met twee JSON-bestanden voor IP-reeksen, en met een verschillend beleid rond robots.txt. Zet ze niet op één regel, en kopieer geen IP-lijst uit een artikel, ook niet uit deze blog: de officiële JSON is de bron, en die lijst kan wijzigen. Een Allow voor PerplexityBot betekent niet dat Perplexity-User opeens robots.txt gaat volgen. Een Disallow voor PerplexityBot haalt je site uit de zoekindex van Perplexity, niet automatisch uit elk antwoord dat een gebruiker triggert via Perplexity-User.
Verwar dit ook niet met GPTBot of Google-Extended. Die gaan over andere merken en andere doelen, van training tot andere vormen van gebruik. Een algemeen “Disallow: /” onder User-agent: * raakt meer dan je denkt, inclusief gewone zoekcrawlers als je niet uitkijkt. Werk met specifieke blokken per agent, documenteer de wijziging, en kijk na 24 uur in je logs of PerplexityBot zich aan de nieuwe regel houdt. Doet hij dat niet, check dan eerst of een WAF de zaak vertroebelt, en of je naar de juiste user-agent hebt gekeken, voordat je de hele robots.txt overhoop haalt.
Wil je wél in de zoekresultaten van Perplexity zichtbaar zijn, dan is toestaan van PerplexityBot de eerste technische stap, geen garantie op een vermelding. Inhoud, bereikbaarheid en hoe je site verder is ingericht, blijven meetellen. Wil je dat juist niet, dan is blokkeren van PerplexityBot een duidelijke keuze, die je los kunt zien van de vraag hoe je met gebruikersverzoeken via Perplexity-User omgaat.
Wat je in je logs terugziet
Als je PerplexityBot toestaat, kun je in de access logs de user-agent en het bron-IP terugvinden. Vergelijk dat IP met de actuele JSON, niet met een afdruk van vorig jaar. Zie je wel verzoeken, maar geen bijbehorende vermeldingen in Perplexity, dan is dat geen fout in robots.txt alleen: zichtbaarheid in de resultaten hangt van meer af dan van een Allow-regel.
Zie je juist geen PerplexityBot, terwijl je hem toestaat, dan kan een WAF, een rate-limit of een verouderde IP-regel de bot tegenhouden. Of de bot is jouw site in die 24 uur na een wijziging nog niet opnieuw tegengekomen. Pas niet elke dag de robots.txt aan om “te testen”; geef een wijziging de tijd, en wijzig één ding tegelijk, zodat je weet wat het verschil maakte.
Tot slot: robots.txt is een afspraak met welwillende crawlers, geen slot op je server. PerplexityBot volgt die afspraak volgens de documentatie; andere agents en andere merken doen dat op hun eigen manier. Blijf de officiële documentatie van Perplexity gebruiken als bron, en behandel blogs, inclusief deze, als toelichting die je aan die documentatie toetst zodra er een nieuwe versie staat.
Veelgestelde vragen
Traint PerplexityBot AI-modellen met mijn content?
Volgens de officiële documentatie niet. PerplexityBot is bedoeld om sites in zoekresultaten te tonen, niet om content te crawlen voor basismodellen. Hetzelfde zegt Perplexity over Perplexity-User.
Volgt PerplexityBot robots.txt?
Ja. Perplexity-User in de regel niet, omdat die ophaalactie op verzoek van een gebruiker gebeurt.
Wanneer is een wijziging zichtbaar?
Het kan tot 24 uur duren, schrijft Perplexity.
Moet je PerplexityBot toestaan?
Alleen als je in de zoekresultaten van Perplexity wilt kunnen verschijnen. Dat is een keuze, geen plicht.
Bronnen
- Perplexity Docs, Perplexity Crawlers (geraadpleegd 16 november 2026)