Applebot-Extended is een aparte regel in robots.txt waarmee je Apple vertelt of je content gebruikt mag worden om Apples generatieve AI-modellen te trainen. Het is geen crawler die je site bezoekt. Apple schrijft op de supportpagina over Applebot, bijgewerkt op 4 september 2026, dat Applebot-Extended geen webpagina’s crawlt en alleen bepaalt wat Apple mag doen met de data die de gewone Applebot al ophaalt. Blokkeer je Applebot-Extended, dan blijft je site vindbaar in Spotlight, Siri en Safari. Voor een bedrijf dat in AI-antwoorden genoemd wil worden, zijn er dus twee knoppen: Applebot voor vindbaarheid, Applebot-Extended voor training.
Wat is Applebot?
Applebot is de webcrawler van Apple. Volgens Apple gebruikt het bedrijf de data van Applebot voor zoekfuncties in onder meer Spotlight, Siri en Safari. Wie Applebot toelaat in robots.txt, kan in de zoekresultaten van Apple-gebruikers verschijnen.
Apple schrijft er iets bij dat voor AI-zichtbaarheid belangrijk is. De data van Applebot kan ook context en actuele informatie leveren wanneer AI-modellen een antwoord maken in Apple-producten. Als voorbeeld noemt Apple antwoorden op algemene kennisvragen in Siri en Search, met links naar de bronnen die zijn gebruikt. Applebot zelf is dus de crawler die bepaalt of je kunt worden gevonden en geciteerd.
Wat is Applebot-Extended?
Applebot-Extended is een tweede user agent die Apple aanbiedt om het gebruik van je content te regelen. Met Applebot-Extended kies je of je content gebruikt mag worden om de algemene foundation models van Apple te trainen. Die modellen zitten achter generatieve AI-functies in Apple-producten, waaronder Apple Intelligence, diensten en ontwikkelaarstools.
Het verschil met een gewone crawler is groot. Apple schrijft letterlijk dat Applebot-Extended geen webpagina’s crawlt. Je ziet de naam dus niet terug in je serverlogs als bezoeker. De regel werkt alleen als instructie: wat mag Apple doen met wat Applebot al heeft opgehaald?
Het verschil tussen Applebot en Applebot-Extended
| Onderdeel | Applebot | Applebot-Extended |
|---|---|---|
| Wat het is | De crawler van Apple | Een regel over het gebruik van gecrawlde data |
| Bezoekt je site | Ja | Nee |
| Gevolg van blokkeren | Je pagina’s worden niet gecrawld voor Apples zoekfuncties | Je content wordt niet gebruikt om Apples foundation models te trainen |
| Invloed op vindbaarheid in Spotlight, Siri en Safari | Ja | Nee, volgens Apple niet |
| Invloed op ranking in Apple Search | Ja, via crawlen en indexeren | Nee, Apple zegt dat de regel niet wordt meegewogen |
Hoe blokkeer je Applebot-Extended?
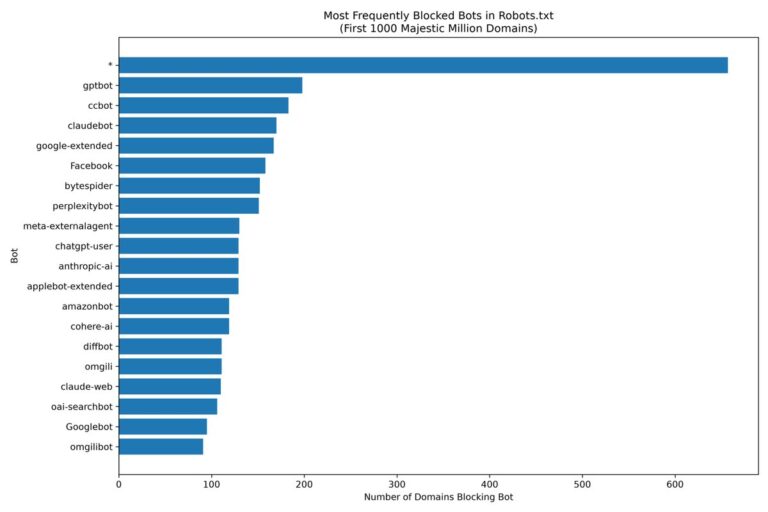
Je blokkeert Applebot-Extended met een regel in robots.txt, net als bij andere bots. Wil je niet dat je hele site wordt gebruikt voor training, dan zet je dit in je robots.txt:
User-agent: Applebot-Extended
Disallow: /
Wil je alleen een deel uitsluiten, dan zet je achter Disallow het pad van die map, zoals Apple in zijn voorbeeld doet met /private/. De gewone Applebot laat je daarnaast gewoon toe. Een regel als User-agent: Applebot met Allow: / is niet nodig zolang je Applebot niet elders blokkeert.
Let op één detail uit de documentatie. Als je robots.txt Applebot niet noemt maar wel Googlebot, volgt Applebot de regels voor Googlebot. Heb je Googlebot ergens uitgesloten, dan geldt dat ook voor Apple. Hoe je de regels voor de crawlers van OpenAI opzet, lees je in het artikel over GPTBot in robots.txt.
Nosnippet: de knop voor AI-antwoorden
Applebot-Extended gaat over training, niet over de AI-antwoorden die Siri en Search met je content maken. Daarvoor noemt Apple een andere route: de meta-tag nosnippet. Zet je nosnippet op een pagina, dan maakt Applebot geen beschrijving of webantwoord van die pagina. Een verwijzing naar de URL toont dan alleen de titel. Apple gebruikt content met nosnippet volgens de documentatie ook niet als extra context wanneer AI-modellen een antwoord maken.
Voor bestanden zonder HTML, zoals pdf’s, ondersteunt Applebot de header X-Robots-Tag: applebot: nosnippet. En wie content achter een betaalmuur heeft, kan met de schema.org-eigenschap isAccessibleForFree op false aangeven dat die pagina betaald is. Apple toont de pagina dan nog wel in zoekresultaten, maar gebruikt de inhoud niet als context voor AI-antwoorden.
Wil je juist in AI-antwoorden van Apple verschijnen, dan zet je dus geen nosnippet op je belangrijke pagina’s. Schema markup die klopt, helpt engines om je pagina te begrijpen. Hoe dat werkt, staat in het artikel over schema markup voor AI.
Wat kies je als bedrijf?
De keuze hangt af van wat je wilt bereiken. Voor de meeste bedrijven die in AI-zoekmachines genoemd willen worden, ziet het er zo uit:
- Applebot toelaten. Zonder Applebot kan Apple je pagina’s niet crawlen voor Spotlight, Siri en Safari, en kan je content ook niet als bron in die antwoorden terechtkomen.
- Applebot-Extended bewust kiezen. Blokkeren heeft volgens Apple geen gevolg voor je vindbaarheid of je ranking in Apple Search. Het gaat alleen om training. Apple schrijft dat toelaten de modellen op termijn beter maakt; wat je daar zelf aan hebt, zegt Apple niet.
- Nosnippet alleen waar het moet. Gebruik de tag voor pagina’s die je bewust niet in een AI-antwoord wilt, zoals betaalde content of interne prijslijsten.
Twijfel je of je robots.txt nu goed staat, kijk dan zelf op jouwdomein.nl/robots.txt of er een regel voor Applebot, Applebot-Extended of Googlebot in staat. Hoe je daarna meet of AI-zoekmachines je noemen, lees je in het artikel over AI-zichtbaarheid meten.
Hoe herken je Applebot in je logs?
Applebot herken je aan de user agent en aan het IP-adres. De user agent bevat het woord Applebot en een link naar apple.com/go/applebot. Apple raadt aan om verkeer te controleren met reverse DNS: echte Applebot-adressen vallen onder het domein applebot.apple.com. Apple publiceert ook een JSON-bestand met de IP-reeksen van Applebot.
Zie je een bezoeker die zich Applebot noemt maar niet uit die reeksen komt, dan is het waarschijnlijk geen Apple. Applebot-Extended zie je nooit in je logs, omdat die geen pagina’s ophaalt. Applebot houdt zich volgens Apple niet aan crawl-delay, maar past zijn tempo zelf aan als een site traag wordt of fouten geeft.
Veelgestelde vragen
Verdwijn ik uit Siri als ik Applebot-Extended blokkeer?
Nee. Apple schrijft dat pagina’s die Applebot-Extended uitsluiten nog steeds in zoekresultaten kunnen verschijnen, en dat je content vindbaar blijft in Spotlight, Siri en Safari.
Crawlt Applebot-Extended mijn site?
Nee. Applebot-Extended crawlt geen webpagina’s. Het bepaalt alleen hoe Apple de data van Applebot mag gebruiken.
Hoe houd ik mijn content uit AI-antwoorden van Apple?
Met de meta-tag nosnippet op de pagina. Apple gebruikt content met nosnippet dan niet als context voor AI-antwoorden, en toont bij die URL alleen de titel.
Telt Applebot-Extended mee voor de ranking?
Nee. Volgens Apple worden de regels voor Applebot-Extended niet meegewogen in de ranking van Apple Search.
Bronnen
- Apple Support, About Applebot (Applebot, Applebot-Extended, nosnippet, X-Robots-Tag, isAccessibleForFree, Googlebot-regel, reverse DNS, rankingfactoren; gepubliceerd 4 september 2026, geraadpleegd 16 november 2026)