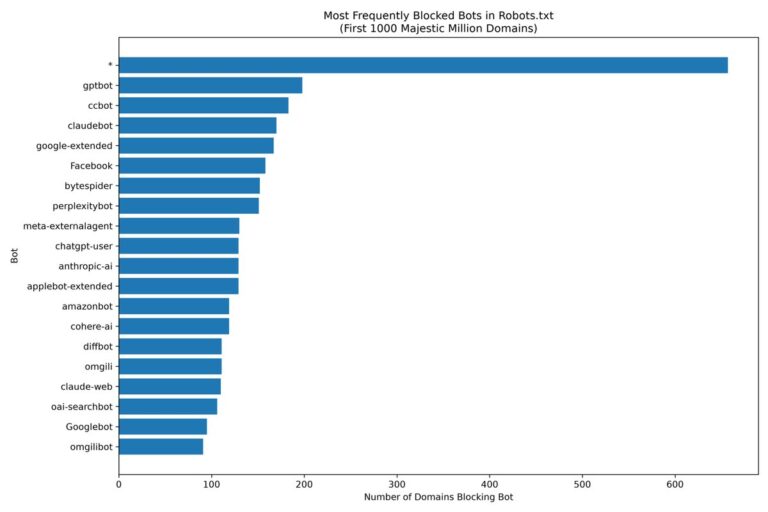
Steeds meer bedrijven ontdekken in hun serverlogs een bezoeker die GPTBot heet. Dat is de crawler van OpenAI. Daarnaast komen ClaudeBot, PerplexityBot, Google-Extended en nog een handvol andere AI-bots langs. De vraag die we bij Word ik genoemd vaak krijgen: moet je die bots in je robots.txt blokkeren of juist toelaten? Het korte antwoord is dat het afhangt van wat je wilt bereiken. Wil je genoemd worden in AI-antwoorden, dan is blokkeren meestal een slecht idee. In dit artikel lees je hoe het werkt, welke bots er zijn en hoe je per bot een bewuste keuze maakt.
Wat is GPTBot?
GPTBot is de webcrawler van OpenAI. Hij bezoekt openbare webpagina’s en verzamelt tekst die OpenAI kan gebruiken om toekomstige taalmodellen te trainen. OpenAI publiceert zelf welke user-agent de bot gebruikt en vanaf welke IP-adressen hij komt, zodat je hem kunt herkennen en desgewenst kunt tegenhouden.
Belangrijk om te weten: OpenAI heeft niet één bot, maar meerdere, elk met een eigen taak.
| Bot | Van | Doel |
|---|---|---|
| GPTBot | OpenAI | Verzamelen van data voor het trainen van modellen |
| OAI-SearchBot | OpenAI | Indexeren van pagina’s voor de zoekfunctie in ChatGPT |
| ChatGPT-User | OpenAI | Pagina’s ophalen als een gebruiker in ChatGPT om een bron vraagt |
| ClaudeBot | Anthropic | Verzamelen van trainingsdata voor Claude |
| PerplexityBot | Perplexity | Indexeren voor de antwoorden van Perplexity |
| Google-Extended | Token waarmee je gebruik voor Gemini-training regelt | |
| CCBot | Common Crawl | Open dataset die veel AI-bedrijven gebruiken |
Dat onderscheid is precies waar veel websites de mist in gaan. Wie alles van OpenAI blokkeert, verdwijnt niet alleen uit de trainingsdata maar ook uit de zoekresultaten binnen ChatGPT.
Hoe werkt robots.txt voor AI-crawlers?
Robots.txt is een tekstbestand in de hoofdmap van je domein, bijvoorbeeld jouwdomein.nl/robots.txt. Daarin geef je per crawler aan welke delen van je site hij mag bezoeken. Fatsoenlijke crawlers lezen dat bestand eerst en houden zich aan je instructies. De grote AI-partijen zeggen allemaal dat hun bots robots.txt respecteren.
Een regel voor een bot bestaat altijd uit een User-agent en een of meer Allow- of Disallow-regels. Zo blokkeer je alleen het trainen door OpenAI, terwijl je wel vindbaar blijft in ChatGPT-zoeken:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: ChatGPT-User
Allow: /
Wil je alle AI-training tegenhouden maar wel zichtbaar blijven in zoekfuncties, dan voeg je vergelijkbare blokken toe voor ClaudeBot, Google-Extended en CCBot. Google-Extended is daarbij een bijzonder geval. Het is geen aparte bot maar een token. Blokkeren heeft geen invloed op je posities in gewone Google-zoekresultaten of in AI Overviews.
Blokkeren of toelaten: de afweging
Er is geen antwoord dat voor iedereen klopt. Het hangt af van je verdienmodel en van wat je met AI-zichtbaarheid wilt.
Redenen om te blokkeren
- Je verdient geld met exclusieve content, zoals een uitgever met betaalde artikelen.
- Je wilt niet dat je teksten zonder vergoeding in trainingsdata belanden.
- De bots belasten je server merkbaar, wat bij kleine hostingpakketten kan gebeuren.
Redenen om toe te laten
- Je wilt dat ChatGPT, Perplexity en Claude je bedrijf noemen als iemand om advies vraagt.
- Je verkoopt een dienst of product en je content is vooral marketing.
- Concurrenten die wel toegankelijk zijn, worden anders genoemd in plaats van jij.
Voor de meeste mkb-bedrijven, dienstverleners en webshops is de keuze dus vrij helder: laat de zoek- en ophaalbots toe. Of je de trainingsbots toelaat is een strategische keuze. Een model dat jouw merk kent uit trainingsdata, noemt je eerder ook zonder live zoekopdracht. Daarom adviseren wij bedrijven die genoemd willen worden om GPTBot in principe niet te blokkeren.
Veelgemaakte fouten
- Alles blokkeren met één regel. Een User-agent: * met Disallow: / houdt ook Googlebot tegen. Dat kost je direct al je organische verkeer.
- Een plugin die stilletjes blokkeert. Sommige beveiligings- en SEO-plugins zetten AI-bots standaard op slot. Controleer je robots.txt na elke update.
- De firewall vergeten. Cloudflare en andere diensten bieden een knop om AI-bots te weren. Die werkt los van robots.txt, dus je kunt in robots.txt alles toestaan en toch geblokkeerd zijn.
- Denken dat robots.txt geheimhouding regelt. Het is een verzoek, geen slot. Gevoelige informatie hoort achter een login.
- Geen onderscheid tussen training en zoeken. Zoals hierboven beschreven heeft vrijwel elke AI-partij meerdere bots.
Zo controleer je wat er nu gebeurt
Open eerst jouwdomein.nl/robots.txt in je browser en kijk welke regels er staan. Zoek op GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot en Google-Extended. Kijk daarna in je serverlogs of hostingdashboard welke van deze bots je site daadwerkelijk bezoeken en of ze een 200 of een 403 terugkrijgen. Een 403 betekent dat een firewall ze tegenhoudt, ook als robots.txt het toestaat.
Gebruik daarnaast een tool om te meten of AI-assistenten je merk noemen. In ons artikel over AI-zichtbaarheid meten lees je hoe dat werkt. Robots.txt bepaalt alleen of bots je site mogen lezen. Of ze je vervolgens ook aanbevelen, hangt af van je content, je vermeldingen op andere sites en de structuur van je pagina’s.
Wat blokkeren wel en niet doet
Blokkeren werkt alleen vooruit. Content die een bot al eerder heeft opgehaald, verdwijnt niet uit bestaande modellen als je vandaag een Disallow-regel toevoegt. Andersom geldt hetzelfde: wie nu toegang geeft, ziet het effect op trainingsdata pas bij een volgende modelversie. Bij zoekbots zoals OAI-SearchBot en PerplexityBot gaat het sneller, omdat die pagina’s live ophalen of regelmatig opnieuw indexeren. Daar zie je een wijziging vaak binnen enkele weken terug in de antwoorden.
Robots.txt en llms.txt
Naast robots.txt duikt steeds vaker llms.txt op. Dat is een voorgesteld bestand waarin je AI-modellen een overzicht geeft van je belangrijkste pagina’s. Het vervangt robots.txt niet. Robots.txt regelt toegang, llms.txt helpt bij begrip. Meer daarover lees je in ons artikel over llms.txt.
Een voorbeeld voor een mkb-bedrijf
Stel, je hebt een installatiebedrijf in Utrecht en je wilt dat ChatGPT je noemt als iemand vraagt naar een betrouwbare installateur voor een warmtepomp. Je content bestaat uit dienstpagina’s, een paar blogs en klantcases. Er is niets exclusiefs dat je wilt afschermen. In dat geval is de beste instelling eenvoudig: laat alle AI-bots toe, ook GPTBot en ClaudeBot. Hoe vaker en beter de modellen jouw pagina’s kennen, hoe groter de kans dat je naam valt.
Een uitgever van vakbladen met betaalde artikelen maakt een andere keuze. Die blokkeert GPTBot, ClaudeBot, CCBot en Google-Extended voor de betaalde secties, maar laat de zoekbots toe op de gratis nieuwsberichten. Zo blijft het merk zichtbaar in AI-antwoorden, terwijl de betaalde content niet zomaar in trainingsdata belandt. Met aparte Disallow-regels per map, bijvoorbeeld Disallow: /premium/, kun je die verdeling precies maken.
Welke keuze je ook maakt: leg hem vast en controleer hem elk kwartaal. Er komen regelmatig nieuwe bots bij, en bestaande bots krijgen soms een nieuwe naam. Een robots.txt die vorig jaar klopte, kan nu gaten hebben of juist te veel tegenhouden.
Onze aanbeveling
Wil je gevonden worden in AI-antwoorden, laat dan in elk geval OAI-SearchBot, ChatGPT-User en PerplexityBot toe. Twijfel je over GPTBot en ClaudeBot, kies dan bewust en leg die keuze vast. Controleer ook je firewall. En meet daarna of je daadwerkelijk wordt genoemd. Hoe je dat aanpakt, lees je in gevonden worden in ChatGPT en in onze GEO-strategie. Wil je het laten monitoren, bekijk dan onze prijzen.
Veelgestelde vragen over GPTBot en robots.txt
Wat is het verschil tussen GPTBot en OAI-SearchBot?
GPTBot verzamelt data voor het trainen van modellen. OAI-SearchBot indexeert pagina’s zodat ze in de zoekresultaten van ChatGPT kunnen verschijnen. Je kunt ze los van elkaar toestaan of blokkeren. Bron: OpenAI, overzicht van crawlers
Verdwijn ik uit Google als ik Google-Extended blokkeer?
Nee. Google-Extended regelt alleen of je content wordt gebruikt voor Gemini-modellen. Het heeft geen invloed op je opname of posities in Google Zoeken. Bron: Google Search Central
Houden AI-crawlers zich echt aan robots.txt?
De grote partijen zeggen dat hun bots robots.txt volgen. Robots.txt blijft wel een verzoek en geen technische blokkade. Wie zeker wil zijn, gebruikt aanvullend een firewall. Bron: Google, introductie robots.txt
Hoe blokkeer ik ClaudeBot?
Voeg een blok toe met User-agent: ClaudeBot en Disallow: /. Anthropic geeft aan dat zijn crawler die instructie respecteert. Bron: Anthropic Help Center
Is robots.txt een officiële standaard?
Ja. Sinds 2022 is het Robots Exclusion Protocol vastgelegd als internetstandaard RFC 9309. Bron: RFC Editor, RFC 9309